A engenheira de sistemas complexos
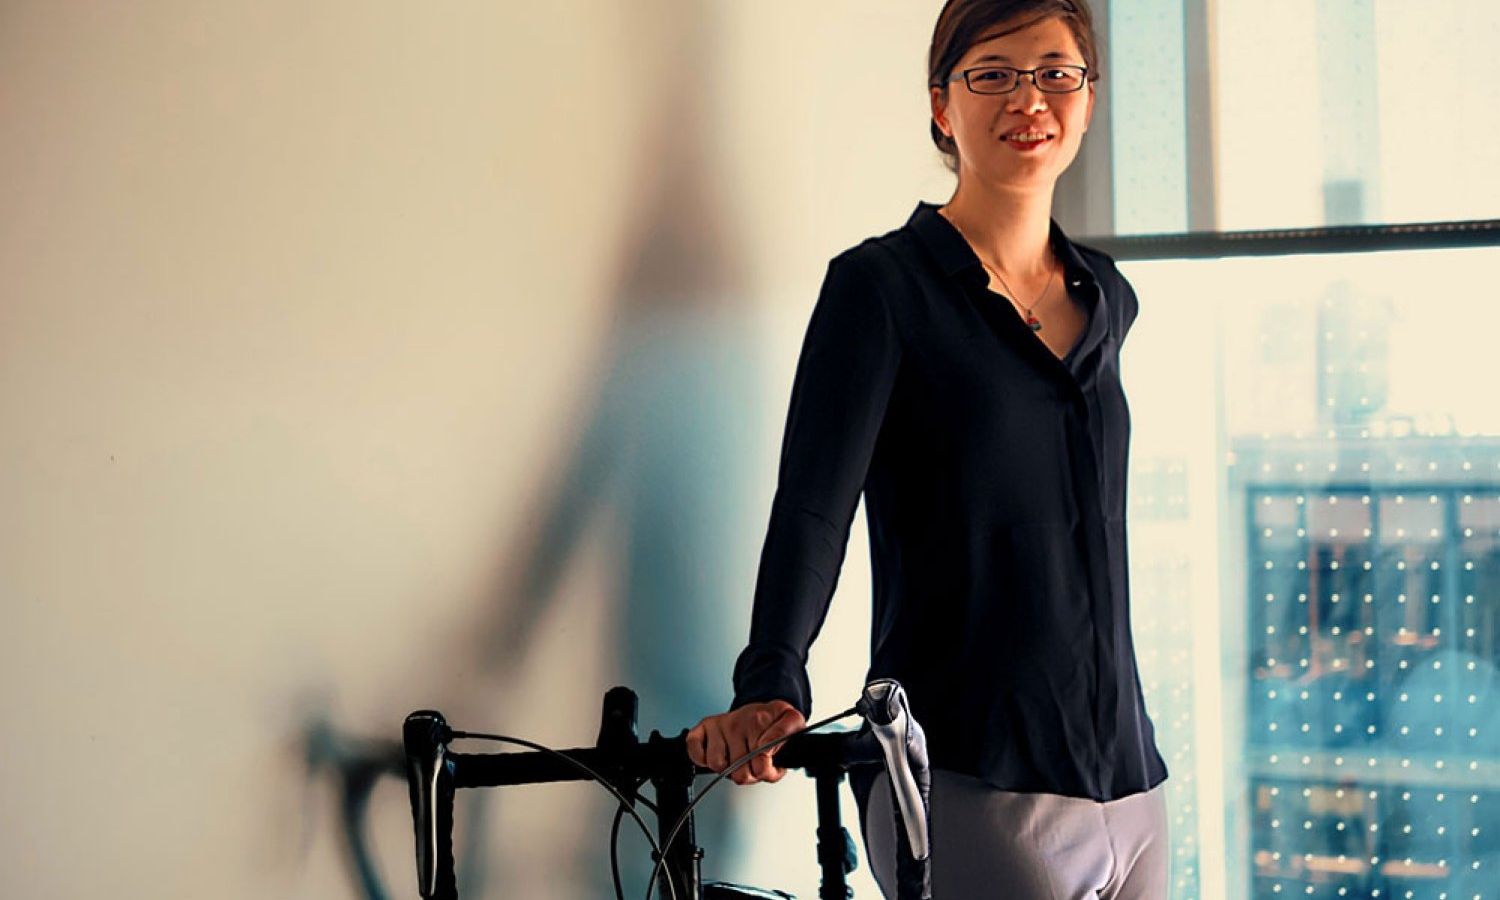
Cathy Wu, professora associada no MIT, dedica sua carreira a desatar os nós dos desafios mais intrincados da sociedade. Sua trajetória, influenciada pela experiência de seus pais imigrantes e pela paixão por jogos de simulação como "SimCity", a levou a aplicar o aprendizado por reforço (RL) para aprimorar sistemas multifacetados, com um foco particular em transporte. Wu acredita que as ferramentas computacionais atuais são insuficientes para modelar e analisar a vasta gama de variáveis envolvidas no design de sistemas de transporte. É nesse vácuo que o RL surge como uma promessa: liberar pesquisadores e profissionais para conceberem sistemas mais eficientes e seguros.
O interesse de Wu em conectar pessoas através de sistemas de transporte é palpável. Ela vê o transporte como uma experiência universal, onde todos compartilham das mesmas dificuldades e anseios por melhorias. Sua inspiração para aplicar inteligência artificial nesse campo remonta a uma palestra sobre veículos autônomos, ministrada pelo professor Seth Teller, um evento que moldou sua abordagem investigativa. Após colaborar com Teller e, posteriormente, com a professora Daniela Rus, Wu aprofundou seus estudos em otimização e RL, culminando em sua tese de doutorado na UC Berkeley. Lá, ela observou a lentidão com que métodos de otimização tradicionais eram desenvolvidos para analisar novas variantes de sistemas, um processo que seu trabalho em ciência da computação prometia acelerar exponencialmente.
O desafio da sensibilidade do RL
Em 2018, Wu obteve um sucesso notável ao aplicar RL para analisar o impacto potencial de veículos autônomos no fluxo de tráfego, um estudo que ganhou grande repercussão. No entanto, a jornada com o RL provou ser desafiadora. Nos anos seguintes, tentativas subsequentes de aplicar a técnica a problemas de tráfego falharam, gerando incerteza sobre a causa: se era ela, seus alunos, o domínio do tráfego ou o próprio RL. Apesar disso, a pesquisa inicial serviu como prova de conceito da aplicabilidade do RL em sistemas de transporte. Em 2022, Wu e seus alunos identificaram um problema crucial: a extrema sensibilidade dos algoritmos de RL. Um algoritmo que funciona bem em um problema pode falhar em outro, mesmo que intimamente relacionado.
Essa descoberta, embora frustrante, abriu caminho para uma solução inovadora. Em 2023, Wu e sua equipe desenvolveram um método para contornar essa sensibilidade. Eles descobriram que, embora o RL possa não treinar bem em 90% dos problemas de um conjunto, ele pode ter sucesso em 10% deles. Ao treinar modelos de RL nesses subconjuntos que generalizam bem, os modelos resultantes podem ter um desempenho coletivo superior em problemas relacionados, mesmo aqueles que não seriam solucionáveis por treinamento direto. Essa abordagem, que Wu considera sua maior conquista, devolveu a confiança de que o RL pode, de fato, desempenhar um papel fundamental na resolução de problemas complexos de otimização, especialmente no contexto de problemas relacionados, conhecido como RL contextual.
Implicações para políticas públicas e o futuro
A pesquisa mais recente de Wu aplica o RL a um problema de otimização de transporte com implicações políticas significativas: a redução de emissões veiculares. Seu trabalho demonstra que medidas de "eco-driving", que controlam inteligentemente a velocidade dos veículos para minimizar paradas e arranques desnecessários, podem reduzir as emissões em até 22%. Isso fornece evidências concretas para políticas que visam melhorar a eficiência do sistema e serve como um exemplo poderoso de como o RL pode informar políticas de transporte em questões de importância prática. Wu é uma forte defensora de políticas baseadas em evidências, acreditando que elas são a base de uma sociedade democrática próspera, especialmente diante da complexidade dos sistemas sociais atuais.
Ela argumenta que muitas questões sobre as quais as pessoas debatem podem ser analisadas sistematicamente com dados, levando a respostas objetivas. Essa crença é um dos pilares de sua permanência na academia: entender como a tecnologia pode apoiar a tomada de decisão democrática. O trabalho de Wu e sua equipe tem se concentrado no desenvolvimento de algoritmos que agilizam a criação de solucionadores para problemas complexos de otimização, aplicáveis não apenas ao transporte, mas também a áreas como logística, cadeias de suprimentos, manufatura e alocação de recursos. Esse estilo de pesquisa, que ela descreve como "use-inspired basic research", aborda problemas práticos ao mesmo tempo em que desenvolve conhecimento fundamental que pode ser transladado para outras aplicações.
Perguntas em aberto e o legado do aprendizado
O impacto de Wu se estende além de suas publicações, alcançando seus alunos. Ela valoriza profundamente o ensino e a mentoria, encontrando satisfação em ver o "clique" do aprendizado em seus estudantes. Reconhecida com prêmios como o NSF Faculty Early Career Development Award e o Ole Madsen Mentoring Award, Wu aconselha seus alunos a serem pacientes e a começarem pequeno diante de problemas complexos. Ela enfatiza que o impacto social é uma jornada de longo prazo, não algo a ser alcançado em poucos anos. A curiosidade e a disposição para fazer perguntas são essenciais para desvendar a complexidade dos problemas e identificar as verdadeiras áreas de intervenção.
Wu sugere que, embora a sociedade enfrente desafios complexos, a tecnologia, guiada por uma pesquisa inspirada pelo uso e fundamentada em dados, oferece caminhos promissores para a otimização e a tomada de decisão informada. A questão que permanece é como escalar essas soluções computacionais para além dos laboratórios de pesquisa e integrá-las efetivamente nas estruturas de governança e infraestrutura que moldam nosso cotidiano, garantindo que os avanços em IA realmente sirvam ao bem-estar coletivo e à eficiência dos sistemas que sustentam nossa vida em sociedade.
Com reportagem de Brazil Valley
Source · MIT News