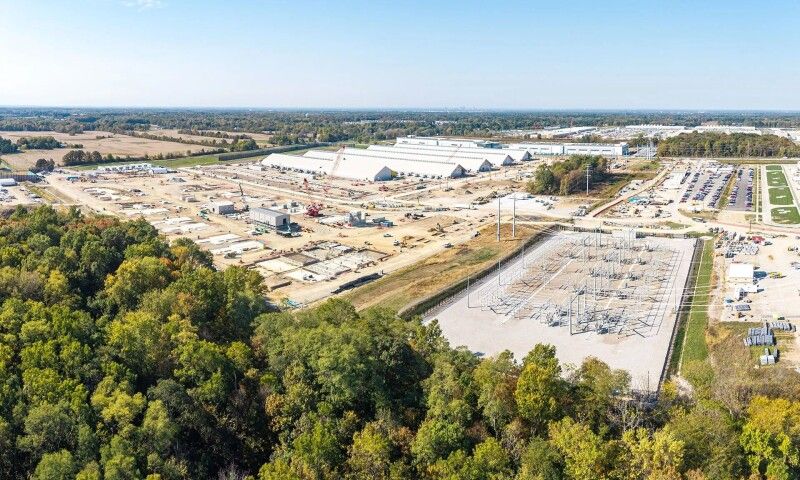
A Meta está mantendo uma parte significativa de suas GPUs Nvidia em estado de ociosidade em seu supercluster Prometheus, localizado em New Albany, Ohio. A revelação, feita pela própria companhia, indica que mais de 11% dos aceleradores estão inativos, servindo como reservas para substituir unidades que falharem durante os intensos processos de treinamento de modelos de inteligência artificial. Esta estratégia de redundância é crucial para a empresa, que almeja manter em operação um ecossistema com cerca de um milhão de GPUs, uma escala sem precedentes.
O Custo da Continuidade: GPUs Ociosas como Rede de Segurança
O supercluster Prometheus, um dos maiores empreendimentos de computação da Meta até o momento, utiliza sistemas Nvidia Grace Blackwell e, futuramente, Vera Rubin. A ambição é escalar a capacidade para um gigawatt, abrigando aproximadamente um milhão de aceleradores. Contudo, a complexidade inerente a clusters de tal magnitude torna falhas de hardware inevitáveis. No início da implantação de Prometheus, a Meta registrava cerca de mil interrupções por dia para cada 8.000 GPUs. Interrupções, que não necessariamente indicam falha de GPU, mas qualquer travamento ou timeout que force a interrupção do treinamento e o retorno ao último ponto de salvamento conhecido. A empresa afirma ter reduzido esse índice em 99%, para cerca de 11 interrupções por dia por 8.000 GPUs, em grande parte graças à reserva de unidades.
Resiliência Paralela: Mitigando Falhas em Larga Escala
Para contornar o impacto de falhas individuais, a Meta emprega a paralelização de dados, onde múltiplas cópias do modelo residem no cluster. Quando uma falha é isolada a uma réplica de modelo paralela de dados, apenas essa unidade é retirada de operação. O restante do cluster continua o treinamento, e a unidade comprometida é reiniciada em hosts disponíveis, sincronizando-se e convertendo uma potencial paralisação total do sistema em uma redução temporária e menor da vazão agregada. Além disso, um sistema robusto de checkpointing salva o estado do modelo de forma assíncrona, atuando como um "auto-save" para evitar a necessidade de recomeçar os treinamentos do zero em caso de falhas.
Desafios da Conectividade e Energia
Um dos maiores obstáculos enfrentados pela Meta foi fazer com que os tecidos NVLink, que conectam 72 GPUs em sistemas Blackwell, funcionassem como um único acelerador. Diferente de sistemas anteriores com oito GPUs por domínio NVLink, a nova geração expandiu essa conectividade nove vezes. Com mais de 600.000 conexões NVLink, até mesmo uma degradação marginal do sinal podia disparar ciclos frequentes de recuperação. Para superar isso, a Meta implementou um sistema contínuo de telemetria e diagnósticos para isolar links fracos antes da produção. A gestão de energia também foi um desafio, com picos de consumo (transientes) ao ligar e desligar dezenas de milhares de GPUs. O foco na estabilidade e confiabilidade permitiu à Meta alcançar mais de 85% de "goodput" (vazão útil) em pré-treinamento e mais de 90% em aprendizado por reforço.
Perspectivas Futuras e Metas de Interrupção
A Meta ambiciona alcançar a marca de um milhão de GPUs em operação. Para isso, a empresa busca reduzir ainda mais a taxa de interrupções, visando apenas duas por dia para cada 8.000 GPUs, o que se traduziria em um tempo médio entre interrupções de cerca de 100.000 horas de GPU. A estratégia de manter GPUs ociosas, embora represente um custo adicional em hardware, é fundamental para a continuidade e eficiência dos seus ambiciosos projetos de IA, garantindo que a corrida pelo desenvolvimento de modelos cada vez mais avançados não seja prejudicada por falhas técnicas.
Com reportagem de Brazil Valley
Source · The Register