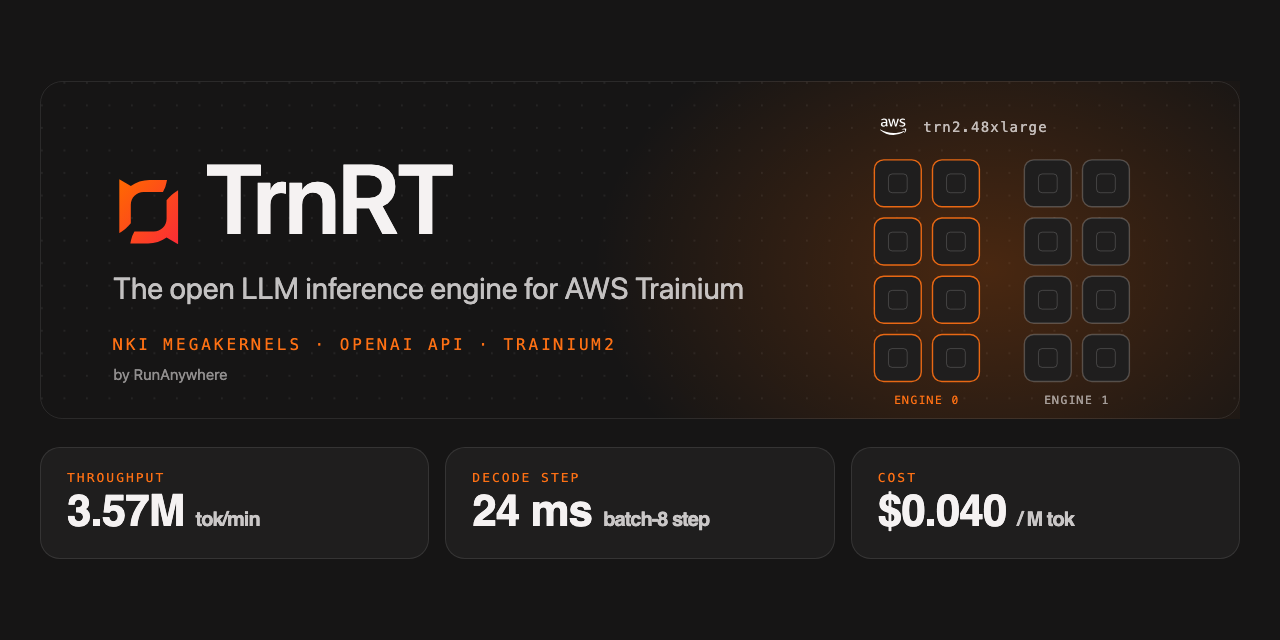
A RunAnywhere, uma startup apoiada pela Y Combinator, anunciou o lançamento do TrnRT (Trainium RunTime), um motor de inferência de código aberto projetado especificamente para os chips AWS Trainium. A iniciativa busca preencher uma lacuna no ecossistema de IA, oferecendo uma solução mais acessível e eficiente para a execução de modelos de linguagem grandes (LLMs).
O TrnRT foi desenvolvido com o objetivo de explorar o potencial dos chips Trainium da AWS, buscando competir em custo-eficiência com hardware de ponta como as GPUs NVIDIA H100 e H200. A empresa destaca que o custo por terabyte de memória em um servidor AWS trn2.48xlarge é inferior à metade do custo de um servidor com 8x H200 na AWS, tornando o Trainium uma opção atraente para cargas de trabalho intensivas em memória, como os modelos MoE com janelas de contexto extensas.
O Desafio da Inferência em Hardware Especializado
Atualmente, a inferência de LLMs em larga escala representa um gargalo significativo para muitas organizações. Embora os chips como os da família Trainium ofereçam vantagens de custo e, potencialmente, de desempenho para tarefas específicas, a falta de suporte robusto de software tem limitado sua adoção. A RunAnywhere identificou que as ferramentas existentes da AWS, como o vLLM Neuron e o NxDI (AWS's own distributed inference framework), não ofereciam suporte imediato para modelos como o GLM-5.3 flash, ou estavam desatualizadas. A ausência de suporte para o Trainium, o único chip da AWS disponível publicamente para inferência, motivou a criação do TrnRT.
O TrnRT foi projetado para otimizar a execução de modelos como o GLM-5.3 flash, que exige uma quantidade considerável de memória. A engine implementa otimizações como a fusão de kernels NKI (Neuron Kernel Interface) para acelerar o processamento, especialmente em camadas com atenção esparsa. Segundo a empresa, essa abordagem resultou em um aumento de 25% na velocidade de decodificação em testes com batch size 8.
Desempenho e Benchmarks
Os primeiros resultados divulgados pela RunAnywhere são promissores. Em um único servidor AWS trn2.48xlarge, o TrnRT conseguiu servir duas instâncias do modelo GLM-5.3 flash com otimizações de cache. Em benchmarks como o AgentX da SemiAnalysis, que simula sessões de agentes de codificação, o sistema alcançou 3.57 milhões de tokens por minuto (TPM). Em testes de desempenho real, o TrnRT suportou 28.9 requisições por minuto (RPM) com 32 agentes em batch 12, e um tempo de primeira resposta (TTFT) de aproximadamente 1.24 segundos com 16 agentes e prompt em cache.
Esses números indicam o potencial do TrnRT em oferecer desempenho comparável ou superior a soluções baseadas em GPUs mais caras, especialmente em cenários de uso intensivo e com janelas de contexto grandes. A otimização para atenção esparsa, que representa um desafio computacional, foi um dos focos do desenvolvimento, visando extrair o máximo do hardware Trainium.
Implicações para o Mercado de IA
O lançamento do TrnRT tem implicações importantes para o mercado de inferência de IA. Ao tornar o hardware AWS Trainium mais acessível e performático através de uma solução de código aberto, a RunAnywhere democratiza o acesso a recursos computacionais de ponta. Isso pode beneficiar startups, pesquisadores e empresas que buscam otimizar custos sem comprometer a performance na implantação de LLMs.
A abordagem da RunAnywhere também desafia o domínio das GPUs tradicionais, incentivando a competição e a inovação em hardware especializado para IA. A empresa planeja expandir o suporte para outros modelos de linguagem e convida a comunidade de código aberto a contribuir para o projeto, acelerando o desenvolvimento e a adoção do TrnRT.
Perguntas em Aberto
Embora os resultados iniciais sejam encorajadores, o TrnRT ainda está em fase de desenvolvimento. Resta saber quão rápido a comunidade abraçará o projeto e quais modelos adicionais serão suportados em curto prazo. A escalabilidade do TrnRT para implantações em larga escala e a sua integração com fluxos de trabalho de produção existentes também são pontos a serem observados. A evolução do suporte de software da própria AWS para o Trainium pode influenciar a trajetória do TrnRT.
O movimento da RunAnywhere sinaliza uma tendência crescente na indústria de IA: a busca por soluções de hardware e software mais eficientes e acessíveis. O TrnRT, ao focar no ecossistema AWS Trainium, pode se tornar uma peça chave para empresas que buscam otimizar seus gastos com inferência de IA, especialmente para modelos de código aberto.
Com reportagem de Brazil Valley
Source · Hacker News