O GitHub anunciou na semana passada, durante o GitHub Universe, uma nova arquitetura de armazenamento Git que promete revolucionar a forma como desenvolvedores e, principalmente, agentes de software interagem com repositórios. Projetada para suportar milhares de escritas por segundo em um único repositório, a inovação é vista como um alicerce fundamental para a adoção em larga escala do desenvolvimento assistido por inteligência artificial (IA), onde centenas de milhões de agentes poderão operar simultaneamente.
O Imperativo da Escalabilidade para Agentes de IA
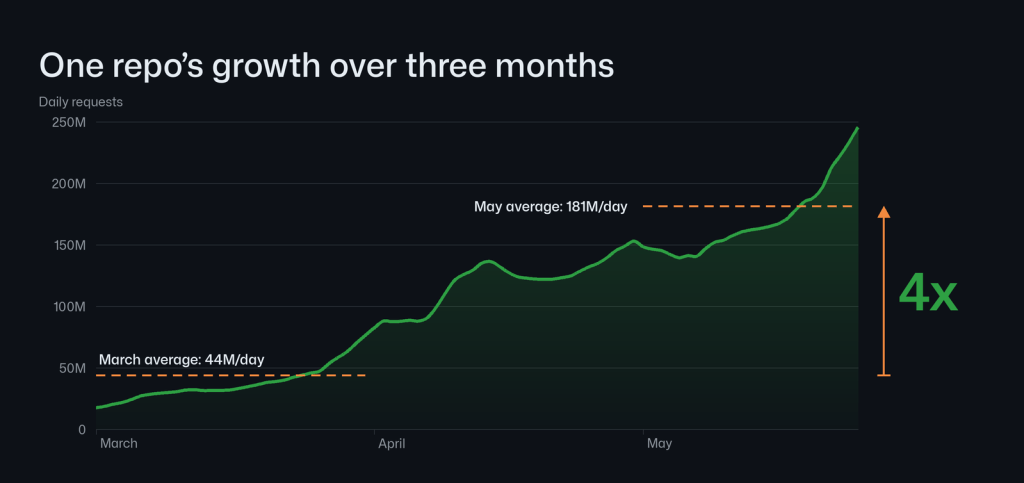
A necessidade de uma nova arquitetura surge do cenário em rápida evolução do desenvolvimento de software. Tradicionalmente, repositórios no GitHub lidam com dezenas de escritas por segundo, geralmente em curtos picos. No entanto, com o advento de agentes de IA que operam continuamente e em paralelo, espera-se que esses picos se transformem em taxas sustentadas de milhares de escritas por segundo em um futuro próximo. Cada uma dessas escritas, por sua vez, gera um número ainda maior de leituras – para execução de testes contínuos (CI), implantações e para que outros agentes busquem o contexto mais recente. O GitHub observou um aumento de até quatro vezes no tráfego de um único repositório em apenas dois meses, uma trajetória exponencial que exige um planejamento antecipado para suportar pelo menos duas ordens de magnitude a mais de escala. A nova arquitetura, apelidada de "Projeto Rubicon", foi desenvolvida com dois princípios centrais: minimizar a coordenação entre os agentes e desacoplar o armazenamento do processamento (compute).
Desacoplando Armazenamento e Processamento com Ref-CAS
A nova arquitetura distribui o armazenamento de dados Git no Azure Blob Storage, aproveitando sua durabilidade, escalabilidade e custo-benefício. No entanto, o desafio reside na gestão das atualizações de referências – a parte crítica de uma operação de push que exige consenso. Em vez de depender de mecanismos de coordenação pesados, o GitHub introduziu o Ref-CAS (Reference Compare-and-Swap), um serviço de log replicado dedicado a gerenciar atualizações de referências de forma eficiente. Cada atualização de referência no Ref-CAS é um compare-and-swap registrado por um quórum, que trava apenas as referências que toca e se torna visível após a gravação pela maioria das réplicas do log. Isso permite que as atualizações ocorram em paralelo, pois a maioria das operações de agentes se concentra em seus próprios branches. Quando duas escritas competem pela mesma referência, apenas uma é anexada ao log. Cada commit recebe um número de sequência de log (LSN), e a versão do repositório é o LSN do seu commit mais recente. Essa abordagem permite que o sistema processe dezenas de milhares de operações de referência por segundo, enquanto os objetos Git em si são armazenados de forma durável no Blob Storage. A leitura é otimizada: se a versão local do agente virtual ainda for a mais recente, nenhuma referência é enviada; caso contrário, ele recebe as referências atuais e ponteiros para os dados necessários no Blob Storage.
Otimização de Leituras e Manutenção em Background
Para lidar com o volume de escritas, a arquitetura também repensa a forma como os dados são mantidos e otimizados. Cada push adiciona um "pack" (um arquivo contendo objetos Git) ao Blob Storage. Embora o Git possa servir um repositório a partir de muitos packs, um número crescente deles torna as buscas mais lentas. A nova arquitetura introduz "compactação" em segundo plano, executada por nós dedicados que operam diretamente sobre o armazenamento durável, sem interferir no serviço de requisições. Esses nós de compactação reivindicam a propriedade de subconjuntos dos dados do repositório através de um "lease" (concessão), permitindo que o processo de compactação escale horizontalmente. Eles agrupam os packs recebidos em segmentos, que são então mesclados em packs maiores e mais eficientes. Essa operação não remove objetos, apenas os reorganiza, mantendo a integridade. A remoção de objetos não referenciados (garbage collection) também é tratada por trabalhadores dedicados. A arquitetura visa que todos os repositórios, desde projetos pessoais até monorepos massivos, operem sob o mesmo sistema, sem a necessidade de migrações ou tratamentos especiais para os mais movimentados. Isso significa que qualquer melhoria feita na arquitetura beneficia instantaneamente todos os repositórios.
O Futuro do Desenvolvimento com Agentes
O GitHub já está planejando os próximos passos, focando em otimizar ainda mais a arquitetura. As melhorias futuras incluem a capacidade de ler apenas os objetos necessários (em vez de packs inteiros), organizar packs por tipo de dado (commits, árvores, blobs), e a implementação de réplicas parciais e globais. A ideia é escalar a infraestrutura de forma dinâmica, aproximando os dados dos usuários e reduzindo a latência. Além disso, o GitHub trabalha para tornar as operações dos agentes mais eficientes, permitindo que trabalhem sem a necessidade de um clone completo, utilizando uma API atômica para commits e streams de eventos em tempo real. A colaboração com o projeto Git também continua, com foco em otimizar clones leves (partial clone, shallow clone, sparse checkout) e remover gargalos de desempenho ocultos. O objetivo final é evoluir o próprio Git para melhor atender às demandas do desenvolvimento assistido por IA, onde a linha entre o trabalho humano e o automatizado se torna cada vez mais tênue. A nova arquitetura está em pré-visualização privada limitada, com um lançamento mais amplo previsto para o início do próximo ano, prometendo um futuro onde a capacidade de um repositório será limitada apenas pela criatividade das equipes.
Com reportagem de Brazil Valley
Source · The GitHub Blog