A TwelveLabs Inc. anunciou o lançamento do Pegasus 1.6, uma evolução significativa em sua plataforma de inteligência de vídeo focada em capacitar a IA física. O novo modelo é projetado para interpretar vídeos egocêntricos – aqueles gravados a partir da perspectiva de quem executa uma tarefa – transformando filmagens do mundo real em conhecimento estruturado que pode ser usado para treinar robôs e sistemas de IA física. A empresa sul-coreana, fundada em 2021, busca preencher uma lacuna crucial: o aprendizado de máquinas a partir da experiência humana em tarefas físicas, algo que tradicionalmente não é capturado em formatos compreensíveis por máquinas.
O Pegasus 1.6 foca em fornecer contexto temporal, raciocínio espacial e julgamento sobre a conclusão de tarefas, aspectos essenciais para a interação segura e eficaz de robôs em ambientes complexos. Jae Lee, cofundador e CEO da TwelveLabs, enfatizou a missão da empresa em ajudar máquinas a entender o mundo através de vídeo, com a IA física sendo a próxima fronteira. Ele destacou que a maioria do conhecimento prático humano, como a forma de segurar um objeto ou reagir a uma queda, nunca foi documentada de maneira que uma máquina pudesse aprender. Com o Pegasus 1.6, a TwelveLabs visa converter essas filmagens em conhecimento acionável, permitindo que equipes de robótica treinem seus sistemas com base na experiência humana real, em vez de começar do zero.
Compreendendo o Vídeo Egocêntrico
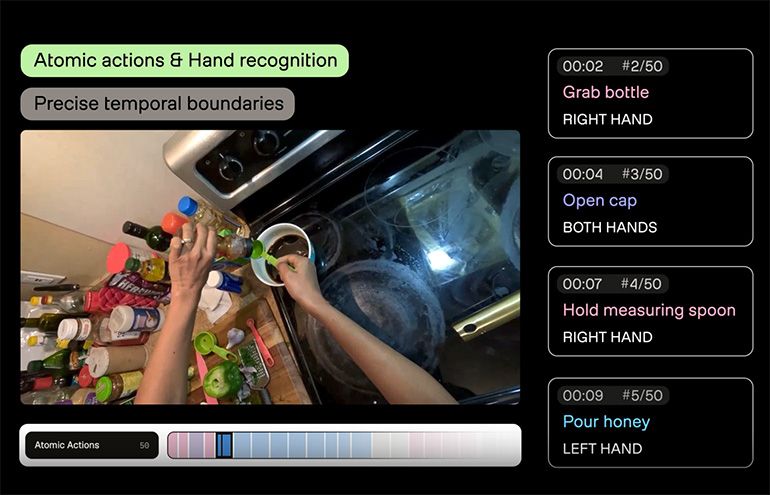
A principal inovação do Pegasus 1.6 reside em sua capacidade de entender vídeo egocêntrico. Diferentemente de vídeos gravados por câmeras fixas ou de perspectivas distantes, o vídeo egocêntrico captura a ação do ponto de vista do operador – seja ele montando uma peça em uma linha de produção, cozinhando ou operando um robô remotamente. Jae Lee explicou que a TwelveLabs não exige câmeras proprietárias, focando na captura das ações e interações do ponto de vista do operador. Essa abordagem é vista como mais escalável do que a coleta de dados de teleoperação, e o modelo é capaz de analisar tanto vídeos quanto imagens estáticas. O objetivo é tornar esses dados mais úteis para equipes de robótica, identificando ações, segmentando-as em intervalos de tempo precisos e capturando detalhes finos do comportamento.
O modelo não se limita a reconhecer ações genéricas. Ele fornece um entendimento mais preciso do que está acontecendo, permitindo que equipes de robótica e ciência de dados convertam essas informações em dados de treinamento valiosos. A TwelveLabs acredita que o vídeo egocêntrico, quando devidamente processado, pode quebrar as limitações de modelos treinados apenas com vídeos de transmissões, instruções ou produções cinematográficas, que muitas vezes carecem da complexidade e nuances do trabalho físico real.
Cinco Fluxos de Trabalho para IA Física
O Pegasus 1.6 suporta cinco fluxos de trabalho principais, todos impulsionados por seu modelo nativo de vídeo. O primeiro é a segmentação e rotulagem de ações, que acelera o treinamento de modelos com conjuntos de dados padronizados ao gerar automaticamente rótulos de ação precisos e com data e hora para tarefas, etapas, objetos e interações mão-objeto. Em seguida, a rotulagem densa de legendas permite o entendimento em linguagem natural para robôs, produzindo descrições ricas para relações espaciais, contexto de cena e interações mão-objeto, treinando políticas de robô avançadas condicionadas à linguagem. O terceiro fluxo é a pontuação de qualidade, que economiza tempo ao filtrar vídeos de baixa qualidade, avaliando automaticamente a clareza da ação, enquadramento e estabilidade antes da revisão humana. O quarto é a busca e curadoria, permitindo a descoberta de casos extremos, cenários de cauda longa e clipes duplicados em todo um repositório de vídeo usando consultas em linguagem natural. Por fim, o quinto fluxo é o de sinalização de consentimento e conformidade, mantendo a privacidade e a conformidade ao detectar e sinalizar rostos, espectadores e dados sensíveis na tela ou em papel antes que os vídeos entrem nos pipelines de desenvolvimento.
Esses fluxos de trabalho demonstram a versatilidade do Pegasus 1.6, indo além da simples identificação de objetos para oferecer uma compreensão profunda do contexto e da dinâmica das ações. A capacidade de gerar metadados de base temporal (TBM) customizáveis e de aprimorar o reconhecimento de entidades para rastreamento consistente de mãos, objetos e ferramentas em diferentes clipes, segundo a TwelveLabs, torna o modelo mais eficiente e econômico para cargas de trabalho de vídeo de alto volume.
Implicações para Robótica e IA
As capacidades do Pegasus 1.6 têm implicações profundas para o avanço da robótica e da IA física. Ao fornecer uma camada de compreensão de vídeo que pode ser integrada com outros sensores, a TwelveLabs está permitindo que os robôs percebam, raciocinem e ajam de forma mais segura e eficaz no mundo real. A capacidade de identificar ações, segmentá-las com precisão temporal e entender as interações entre mãos e o ambiente circundante, mesmo com uma compreensão rudimentar do movimento dos membros, complementa os dados de sensores táteis e de nível de atuador dos robôs. Isso permite que equipes de robótica construam trajetórias e políticas de aprendizado mais precisas.
A colaboração com desenvolvedores de robótica e equipes de dados, focada em aumentar a escala dos dados de treinamento para tarefas como embalagem, montagem, limpeza e controle de qualidade industrial, é um testemunho do potencial da tecnologia. A TwelveLabs argumenta que tornar vídeos de comportamento humano mais úteis para treinamento é uma abordagem muito mais escalável do que a teleoperação. O avanço na análise de vídeo egocêntrico pode acelerar o desenvolvimento de robôs mais capazes e adaptáveis, especialmente em tarefas que exigem destreza e manipulação fina, áreas onde a imitação do comportamento humano é crucial.
Perguntas em Aberto e o Futuro da IA Física
Embora o Pegasus 1.6 represente um salto significativo, várias questões permanecem em aberto sobre o futuro da IA física e o papel da compreensão de vídeo. A capacidade do modelo de generalizar para tarefas e ambientes radicalmente novos, além daqueles representados nos dados de treinamento, será um fator determinante para sua adoção em larga escala. A precisão e a confiabilidade na detecção de nuances sutis do comportamento humano, como intenção ou hesitação, ainda são áreas em desenvolvimento. Além disso, a integração contínua com outras modalidades de sensores e a garantia de que os dados de vídeo processados pela IA respeitem rigorosamente os protocolos de privacidade e conformidade serão essenciais.
O desenvolvimento da TwelveLabs sugere um futuro onde as máquinas não apenas executam tarefas programadas, mas aprendem e se adaptam com base em uma compreensão rica do mundo observada através de vídeo. A evolução contínua de modelos como o Pegasus será crucial para desvendar todo o potencial da IA física, aproximando-nos de robôs mais autônomos, capazes e integrados ao cotidiano humano e industrial.
Com reportagem de Brazil Valley
Source · The Robot Report