A capacidade de robôs aprenderem comportamentos complexos de forma autônoma, por meio de tentativa e erro, tem sido um dos avanços mais significativos no campo da inteligência artificial e robótica. Tradicionalmente, esse aprendizado ocorre em simulações computacionais, onde os robôs podem experimentar livremente sem riscos. No entanto, a transição desse conhecimento para robôs físicos sempre foi um obstáculo considerável, conhecido como "reality gap" – a discrepância entre o comportamento simulado e o real, muitas vezes devido a imprecisões de sensores, atrito e limitações mecânicas.
Superando a barreira da realidade
Pesquisadores do laboratório IRIDIA, da Université libre de Bruxelles (ULB), apresentaram uma solução inovadora para esse problema em robótica de enxames. Em vez de permitir que algoritmos de aprendizado por reforço definam cada movimento individualmente, a nova metodologia restringe o aprendizado a escolher entre um conjunto de comportamentos pré-testados e confiáveis, como mover-se em direção a uma fonte de luz, agregar-se a outros robôs ou explorar o ambiente. A parte crucial que permanece para o aprendizado é decidir quando alternar entre esses comportamentos para otimizar o desempenho coletivo do grupo.
O paradoxo da flexibilidade limitada
Mauro Birattari, um dos líderes da pesquisa, explica que a flexibilidade excessiva dos métodos de aprendizado por reforço tradicionais pode levar ao "overfitting" da simulação. Ou seja, o algoritmo aprende a explorar peculiaridades do ambiente simulado que não existem na realidade. Ao impor uma estrutura e limitar as opções de aprendizado, a nova abordagem força o algoritmo a focar nas decisões que são verdadeiramente relevantes e transferíveis para o mundo físico. Essa "tendência estrutural" (structural bias) garante que os robôs aprendam a tarefa em si, e não apenas a simulação.
Testes e resultados promissores
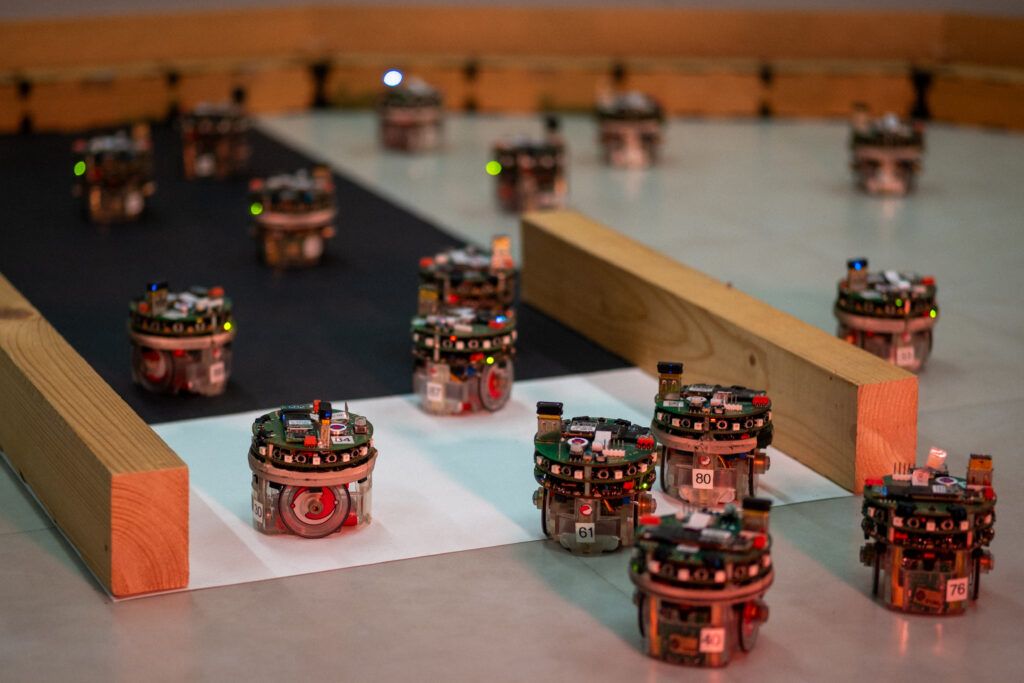
A equipe validou o método em um enxame de 20 robôs e-puck, realizando 250 experimentos em missões coletivas variadas. Os resultados foram notáveis: os enxames treinados com a nova abordagem demonstraram um desempenho substancialmente superior e mais confiável em comparação com métodos de ponta que controlam diretamente os motores dos robôs, os quais falharam em manter a performance fora da simulação. A pesquisa também confirmou que políticas de aprendizado mais simples e restritas transferiram melhor para a realidade do que modelos maiores e mais flexíveis, contrariando a intuição comum em IA de que modelos mais complexos são sempre superiores.
Implicações para o futuro da robótica
Ilyes Gharbi, o primeiro autor do estudo, destaca o potencial da abordagem para tornar o aprendizado por reforço uma ferramenta prática para robótica de enxames. Isso significa que, no futuro, projetar comportamentos coletivos complexos para missões como busca e salvamento, monitoramento ambiental ou exploração de locais perigosos poderá ser feito com mais rapidez e confiança, treinando os robôs em simulação e implementando-os no campo com a certeza de que operarão como esperado. Os próximos passos incluem testar a metodologia em enxames maiores e em ambientes menos controlados.
Com reportagem de Brazil Valley
Source · Robohub